Accélérateurs IA et serveurs de calcul
Catalogue complet du matériel de calcul IA chinois : cartes d'accélération, serveurs de calcul, supernodes et modules de Huawei Atlas, MetaX, Hygon, Biren, Moore Threads et Alibaba. Sélectionnez un modèle pour consulter les caractéristiques et demander un devis.
Huawei Atlas
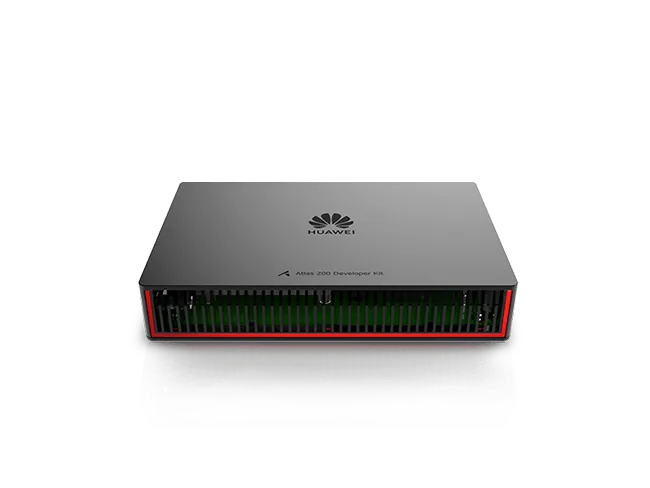
Atlas 200I DK A2 Developer Kit
Kit de développement IA simple et prêt à l'emploi pour innover rapidement Voir les détails →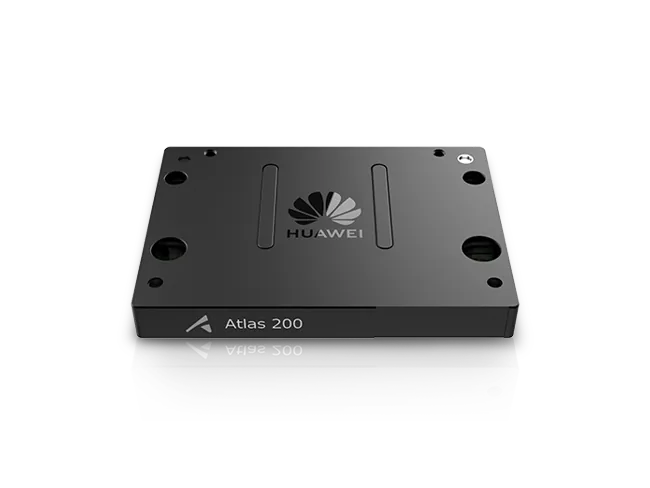
Huawei Atlas
Atlas 200I A2 Acceleration Module
Module d'accélération IA embarqué dans les dispositifs intelligents périphériques, robots... Voir les détails →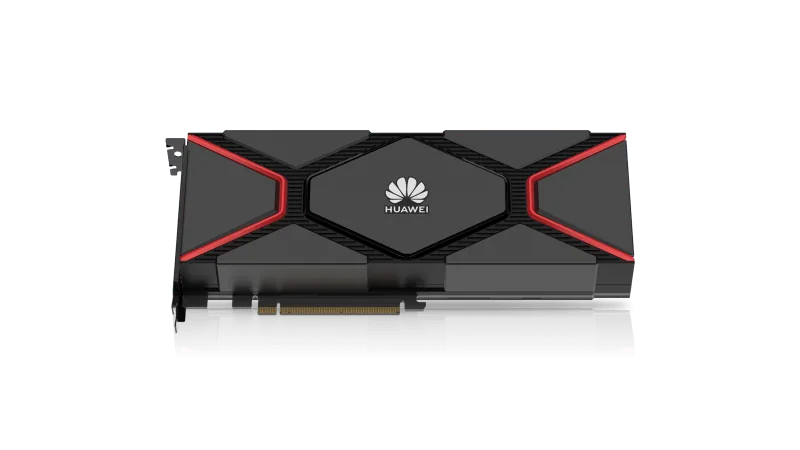
Huawei Atlas
Atlas 300I A2 Inference Card
Carte d'inférence IA intégrée aux serveurs pour une puissance de calcul exceptionnelle Voir les détails →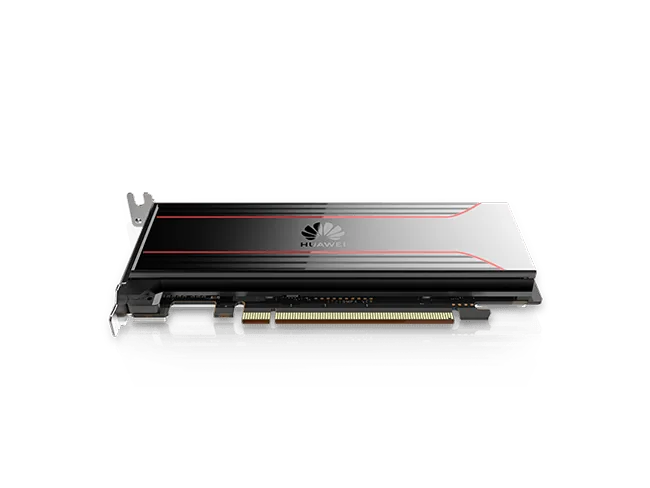
Huawei Atlas
Atlas 300I Pro Inference Card
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →
Huawei Atlas
Atlas 300I Duo Inference Card
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →
Huawei Atlas
Atlas 300V Video Analysis Card
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →
Huawei Atlas
Atlas 300V Pro Video Analysis Card
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →
Huawei Atlas
Atlas 500 A2 Intelligent Edge Station
Mini-station IA sans ventilateur pour l'edge, robuste en environnement rude... Voir les détails →
Huawei Atlas
Atlas 500 Pro Intelligent Edge Server (Model 3000)
Serveur edge à puissance de calcul exceptionnelle Voir les détails →
Huawei Atlas
Atlas 800 Inference Server (Model 3000)
Serveur IA à puissance de calcul exceptionnelle Voir les détails →
Huawei Atlas
Atlas 800T A2 Training Server
Serveur IA à puissance de calcul exceptionnelle Voir les détails →
Huawei Atlas
Atlas 800I A2 Inference Server
Serveur IA à puissance de calcul exceptionnelle Voir les détails →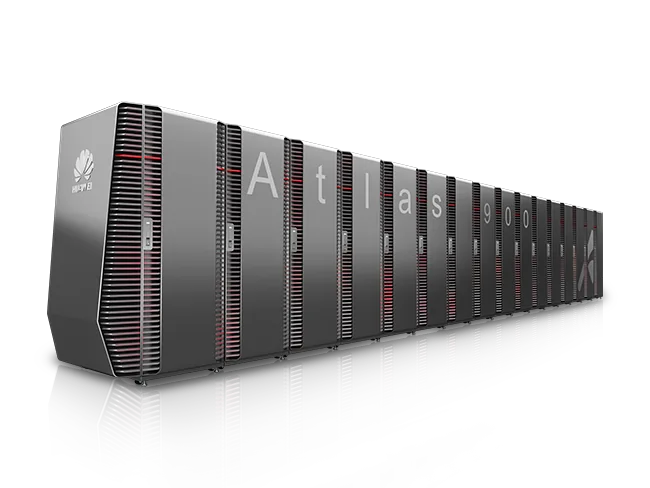
Huawei Atlas
Atlas 900 AI Cluster
Grappe d'entraînement performante pour les centres de calcul IA et autres scénarios à... Voir les détails →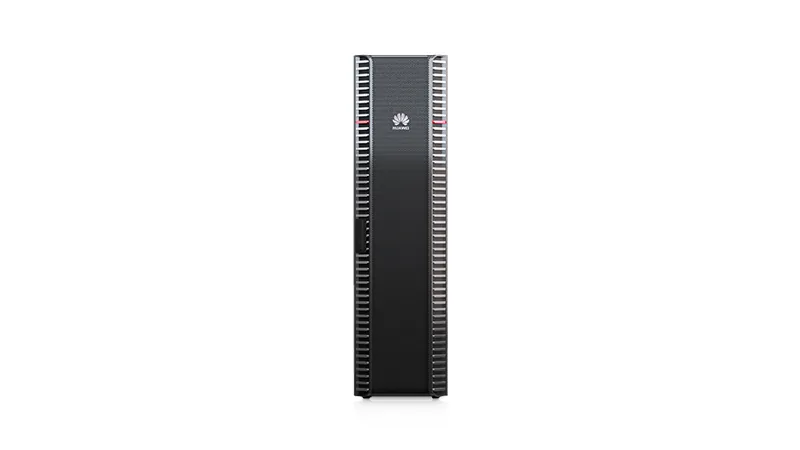
Huawei Atlas
Atlas 900 A2 PoD Base Unit
Unité de base de grappe d'entraînement performante pour les centres de calcul IA et... Voir les détails →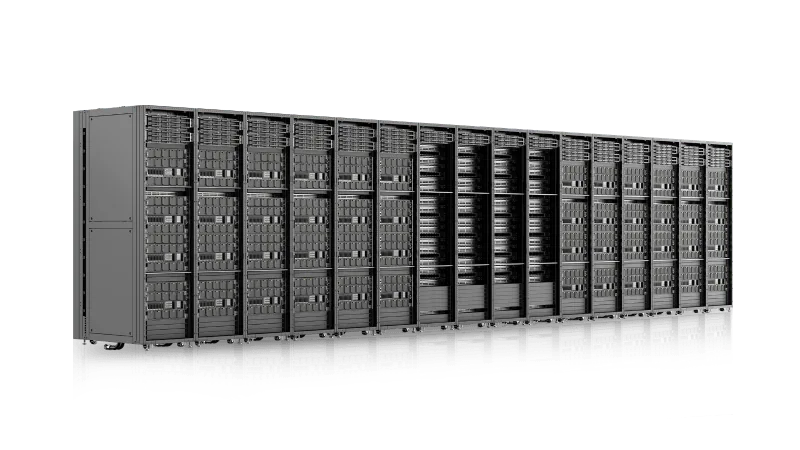
Huawei Atlas
Atlas 900 A3 SuperPoD
Supernœud d'entraînement à hautes performances et haute efficacité, refroidi par liquide Voir les détails →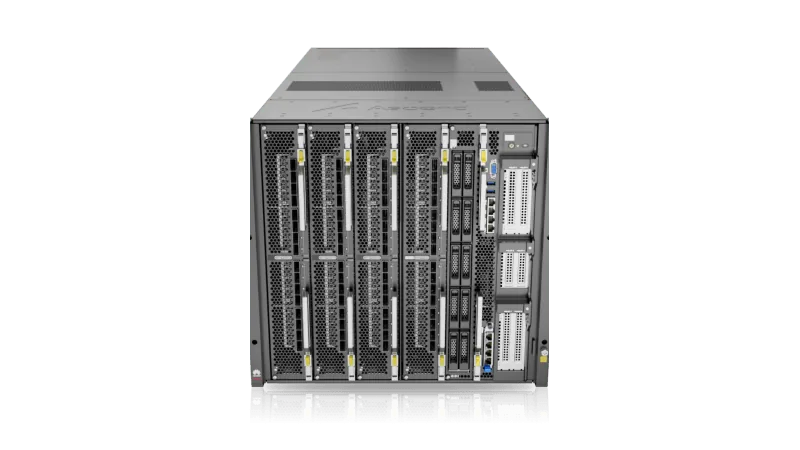
Huawei Atlas
Atlas 800T A3 Supernode Server
Serveur supernœud d'entraînement à hautes performances, haute efficacité (déploiement en... Voir les détails →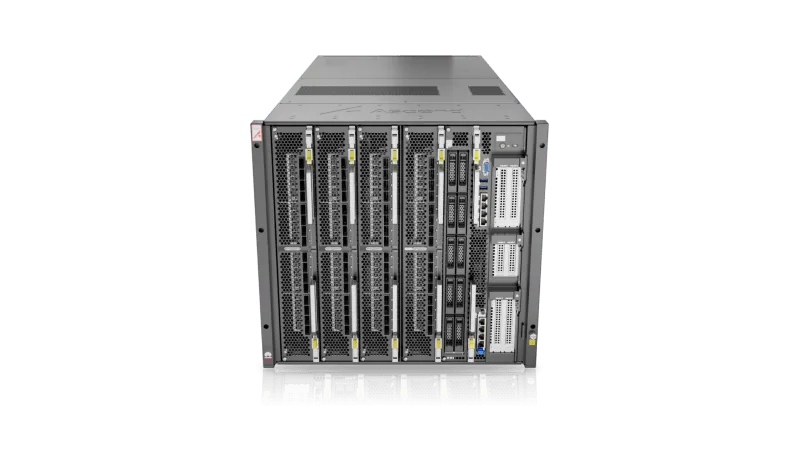
Huawei Atlas
Atlas 800I A3 Supernode Server
Serveur supernœud d'inférence à hautes performances, à grande échelle, refroidi par air Voir les détails →
Huawei Atlas
Atlas 150
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →
Huawei Atlas
Atlas 350
Carte standard d'entraînement et d'inférence, intégrée aux serveurs, pour une puissance... Voir les détails →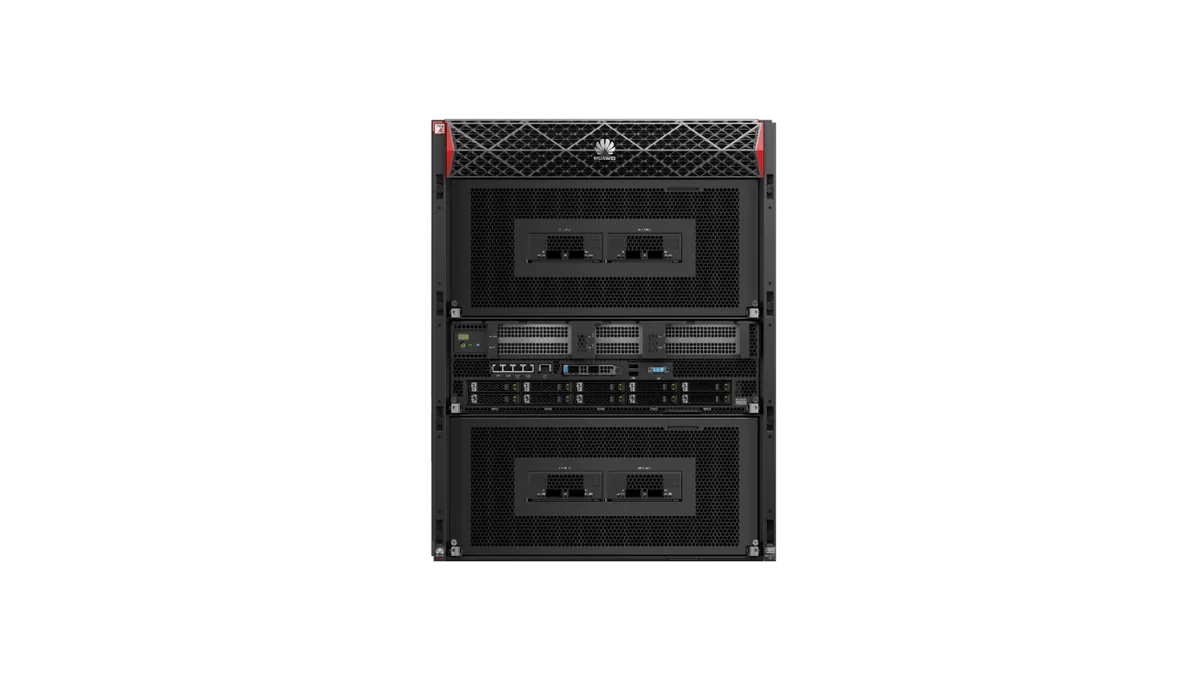
Huawei Atlas
Atlas 650E
Serveur IA à puissance de calcul exceptionnelle Voir les détails →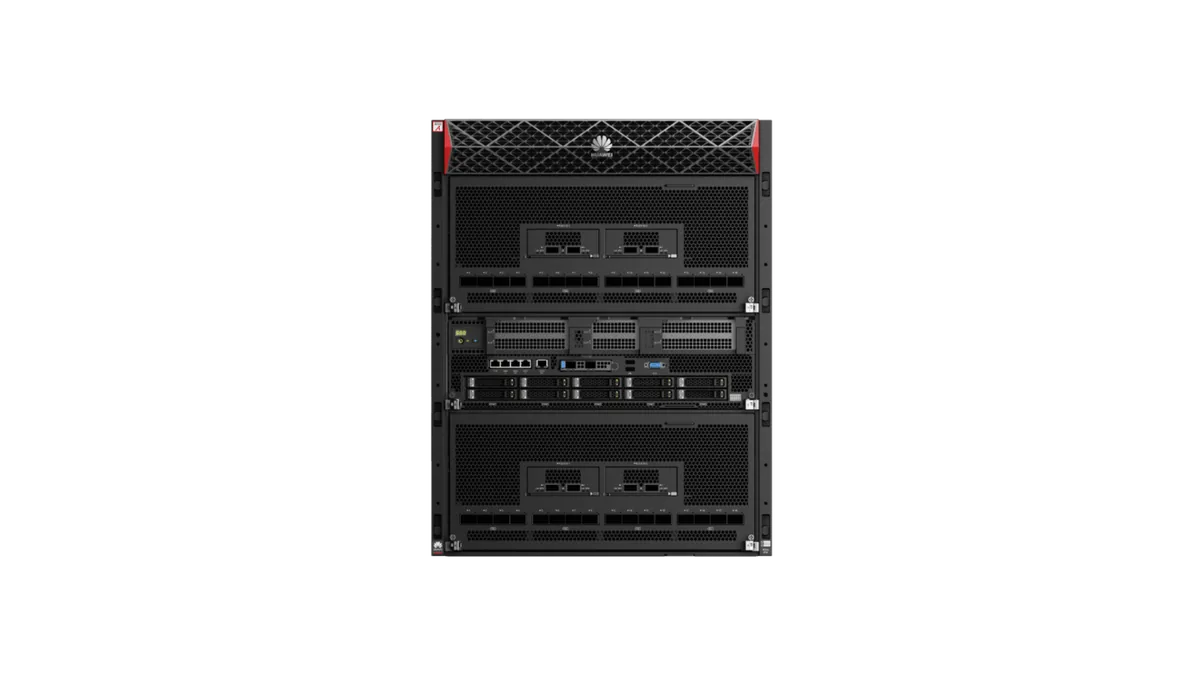
Huawei Atlas
Atlas 850E
Choix idéal pour les centres de données à grande échelle, l'entraînement de modèles... Voir les détails →
MetaX
N100
GPU d'inférence pour calcul intelligent Voir les détails →
MetaX
N260
GPU d'inférence pour grands modèles Voir les détails →
MetaX
N300
GPU d'inférence pour grands modèles Voir les détails →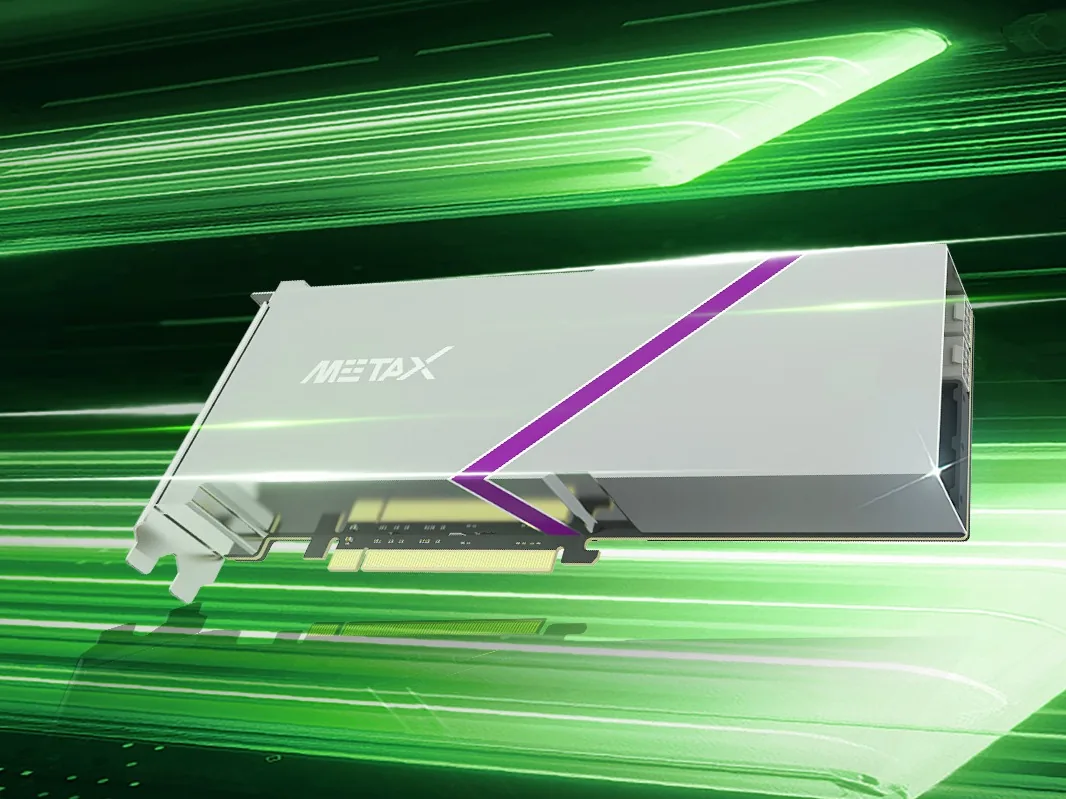
MetaX
C500
GPU généraliste (GPGPU) Voir les détails →
MetaX
C550
GPU généraliste (module OAM) Voir les détails →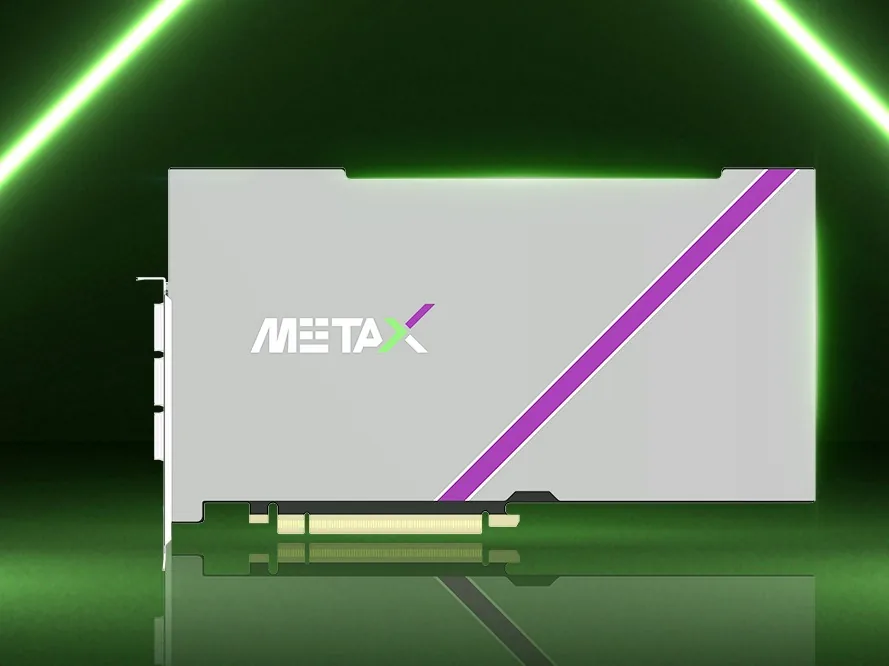
MetaX
C500X
GPU généraliste à interconnexion optique Voir les détails →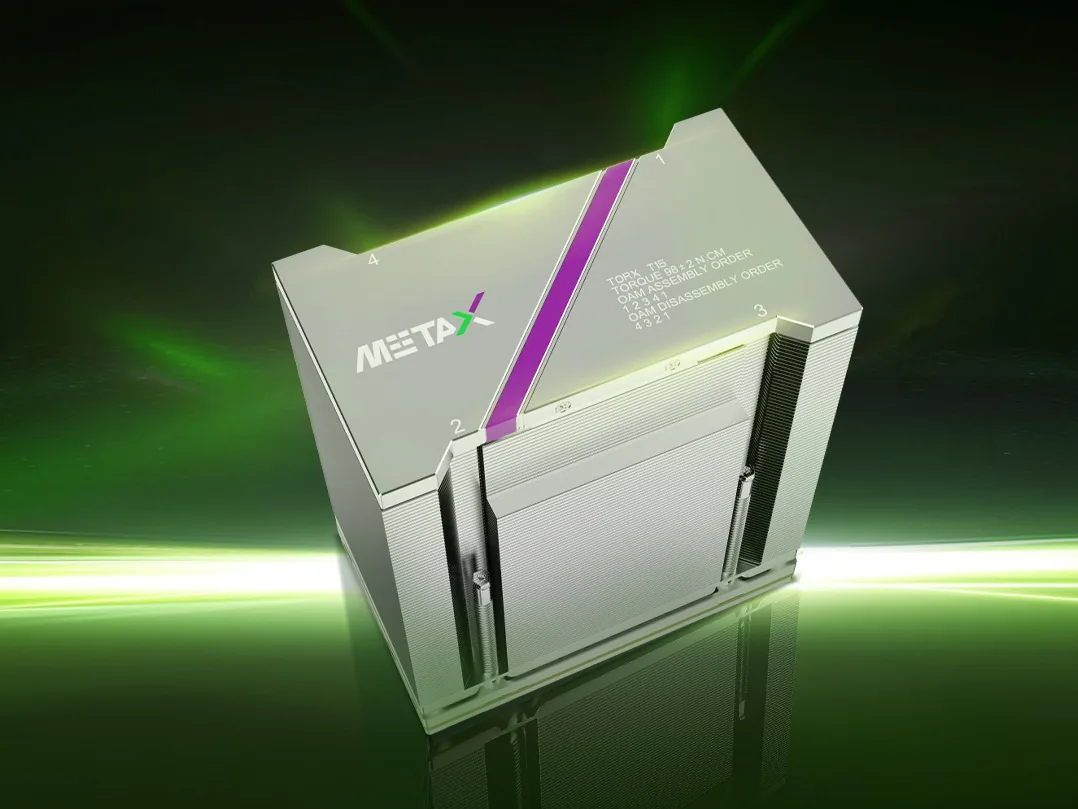
MetaX
C588
GPU généraliste (module OAM flagship) Voir les détails →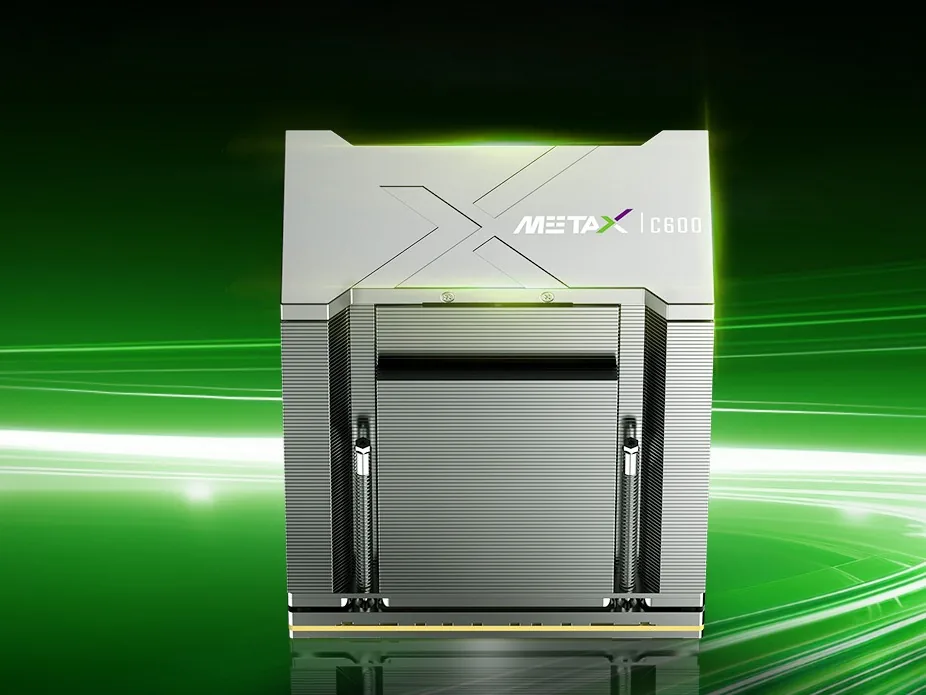
MetaX
C600
GPU généraliste (module OAM, air/liquide) Voir les détails →
MetaX
N260 Server
Serveur GPU d'inférence rack standard Voir les détails →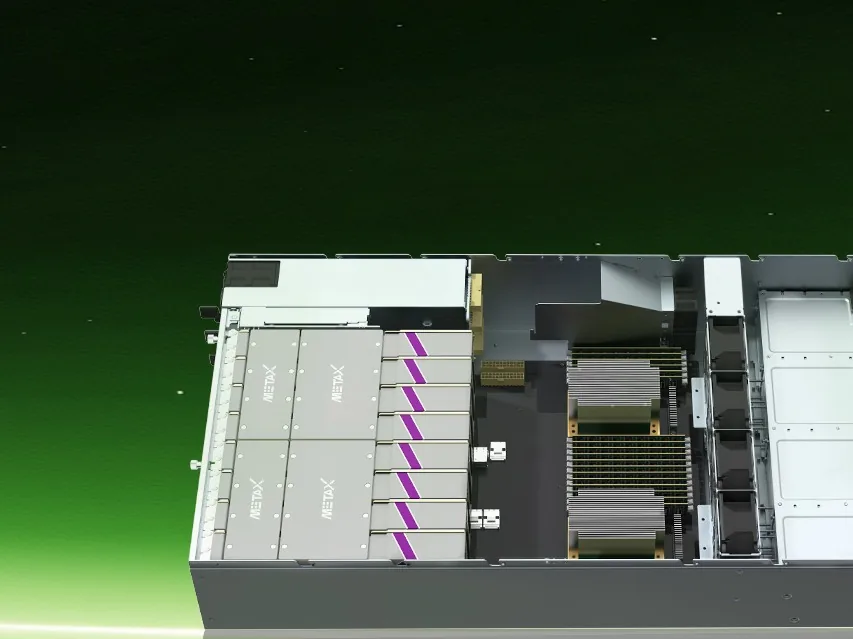
MetaX
N300 Server
Serveur d'inférence IA haute densité et haute concurrence Voir les détails →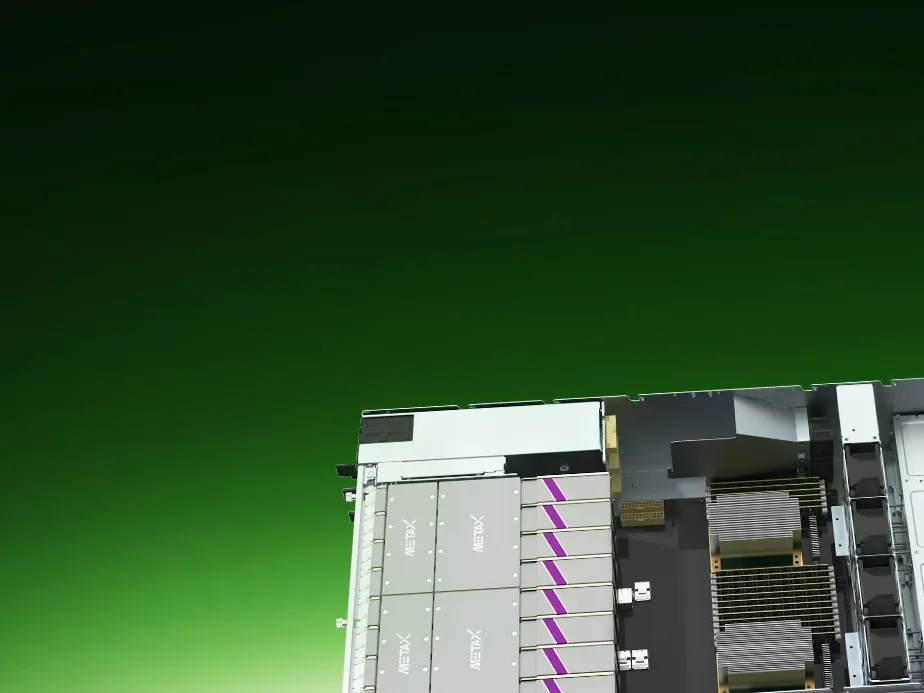
MetaX
C500 Server
Serveur GPU rack standard Voir les détails →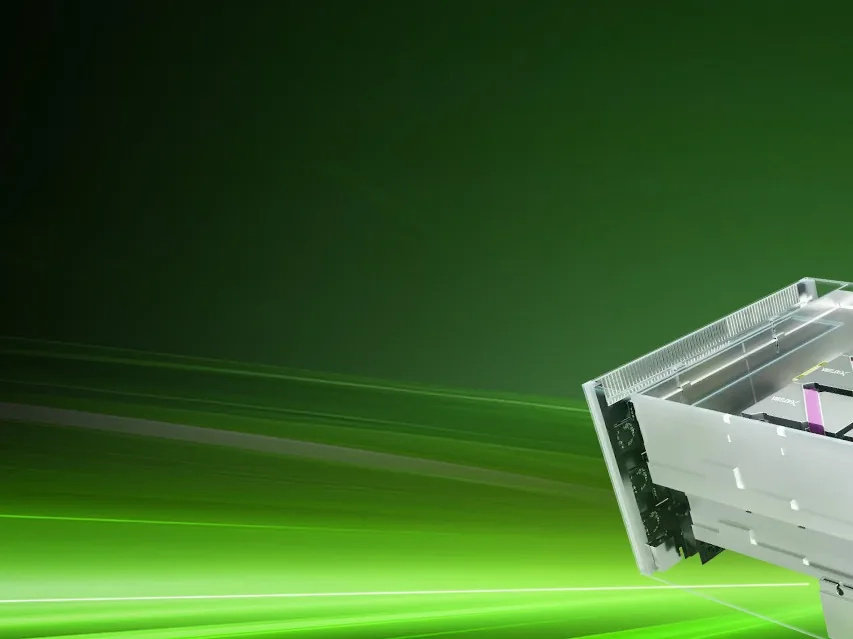
MetaX
C550 OAM Server
Serveur OAM standard double socket flagship Voir les détails →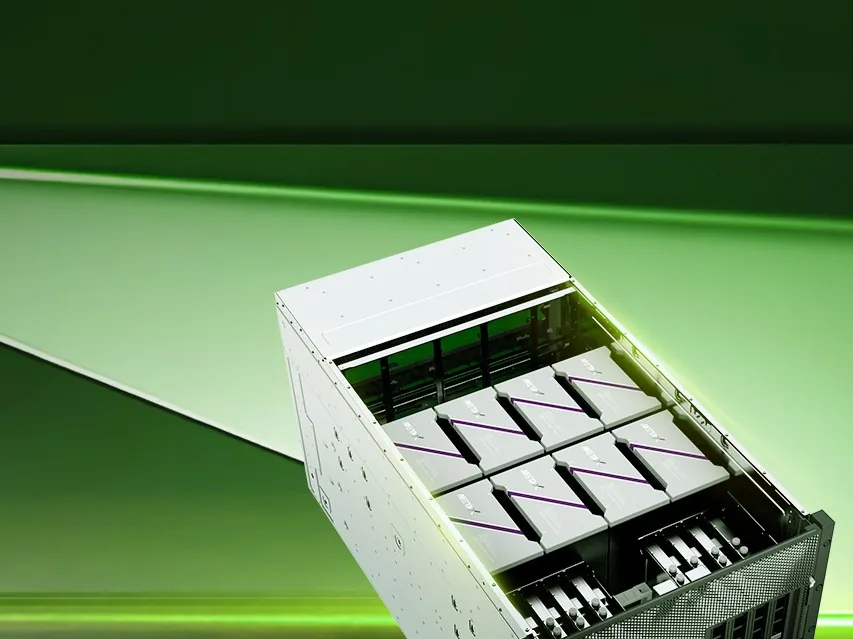
MetaX
C588 OAM Server
Serveur OAM standard double socket flagship (air/liquide convergé) Voir les détails →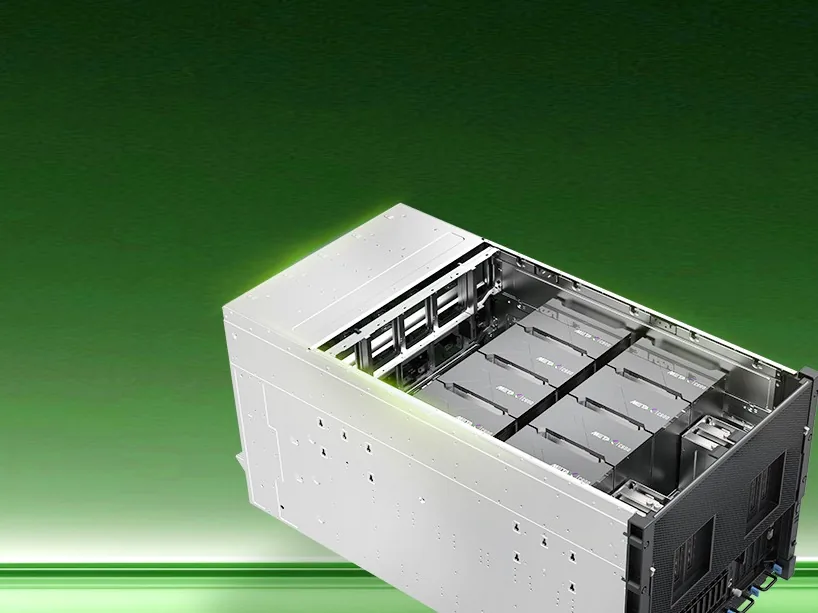
MetaX
C600 OAM Server
Serveur OAM standard double socket flagship Voir les détails →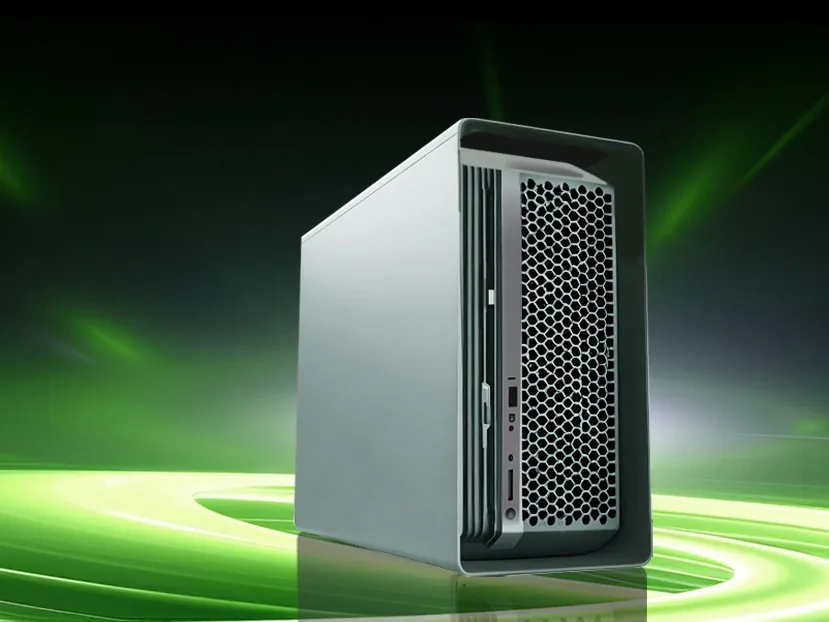
MetaX
N260 Workstation
Station de travail GPU à refroidissement actif (hors salle blanche) Voir les détails →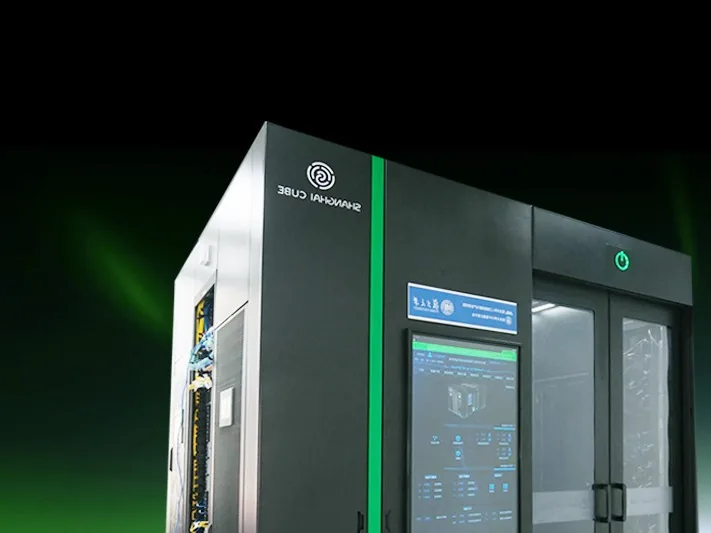
MetaX
C550 Shanghai Cube Liquid-Cooled Cabinet
Baie complète liquide haute densité (128 GPU/baie) Voir les détails →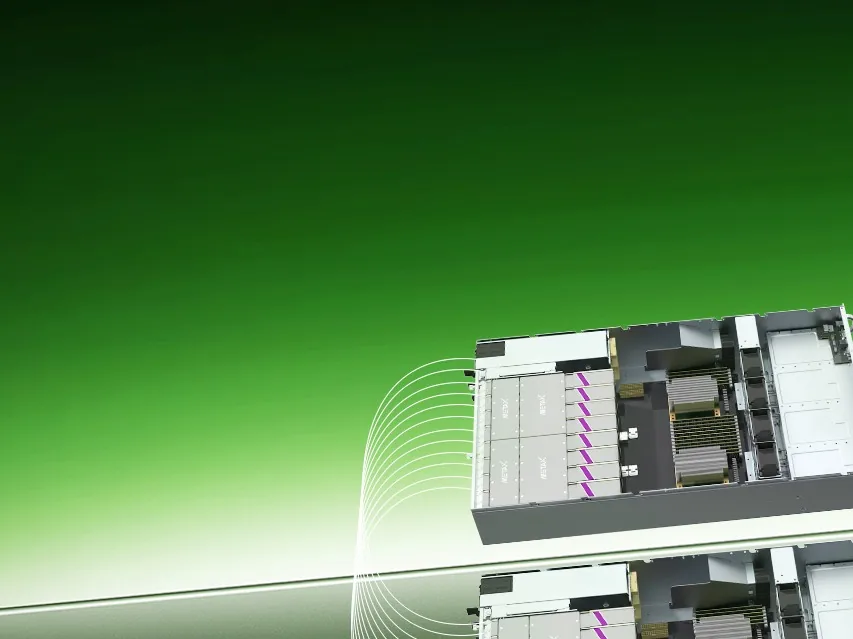
MetaX
C500X Optical-Interconnect Supernode
Supernœud à interconnexion optique (jusqu'à 8 serveurs / 64 cartes) Voir les détails →
MetaX
C550 3D Mesh Supernode
Supernœud 3D Mesh à interconnexion électrique (jusqu'à 8 serveurs / 64 cartes) Voir les détails →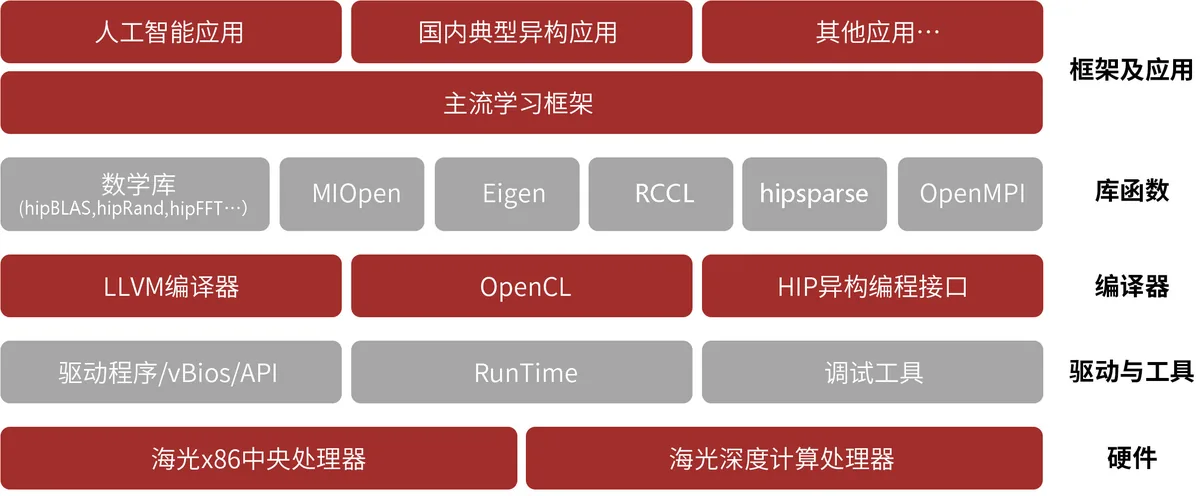
Hygon
Hygon Deep Computing Processor DCU (specific model not disclosed)
Processeur de calcul profond à haute puissance sur architecture de calcul parallèle... Voir les détails →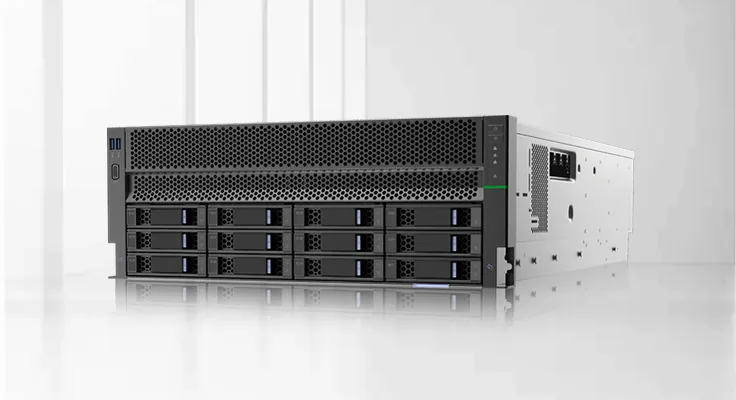
Hygon
Heterogeneous Computing Server (specific model not disclosed)
Serveur de calcul hétérogène dédié au format châssis complet, fondé sur processeurs Hygon Voir les détails →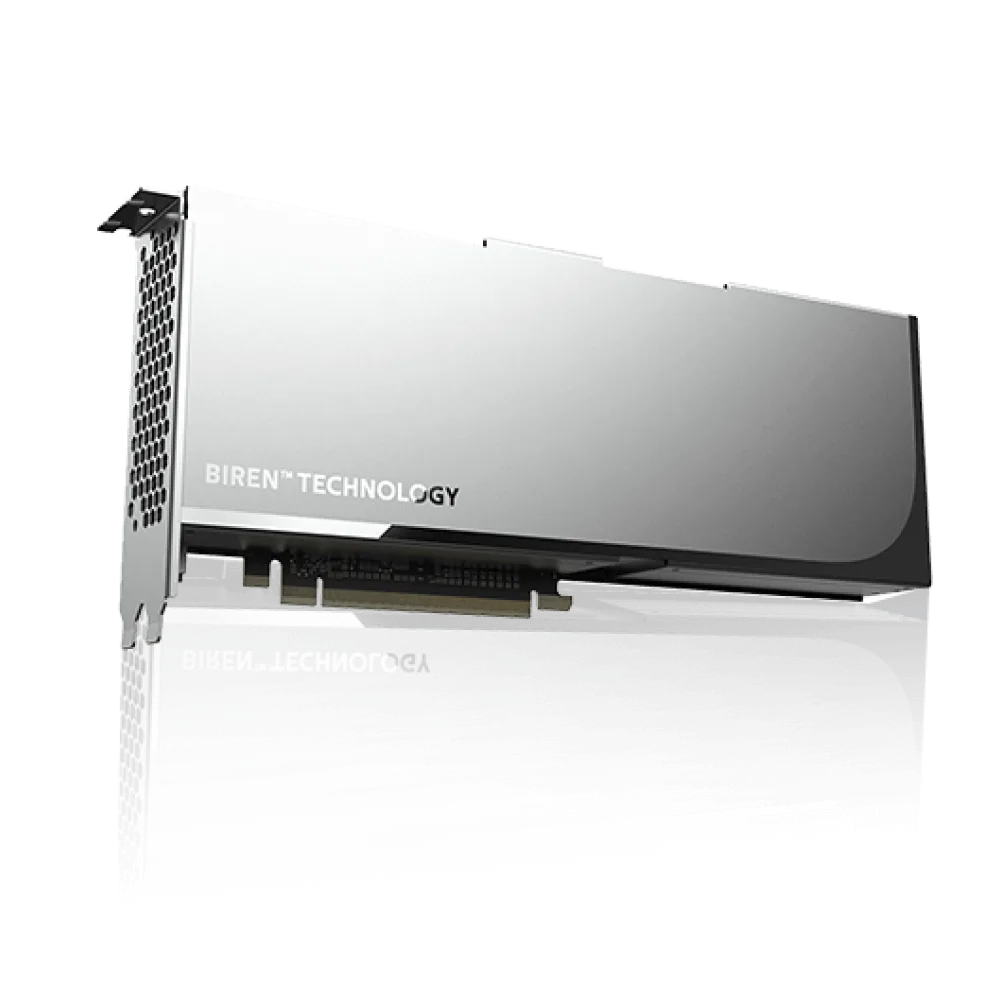
Biren
BIREN 106B
Carte accélératrice PCIe pleine hauteur pleine longueur double largeur... Voir les détails →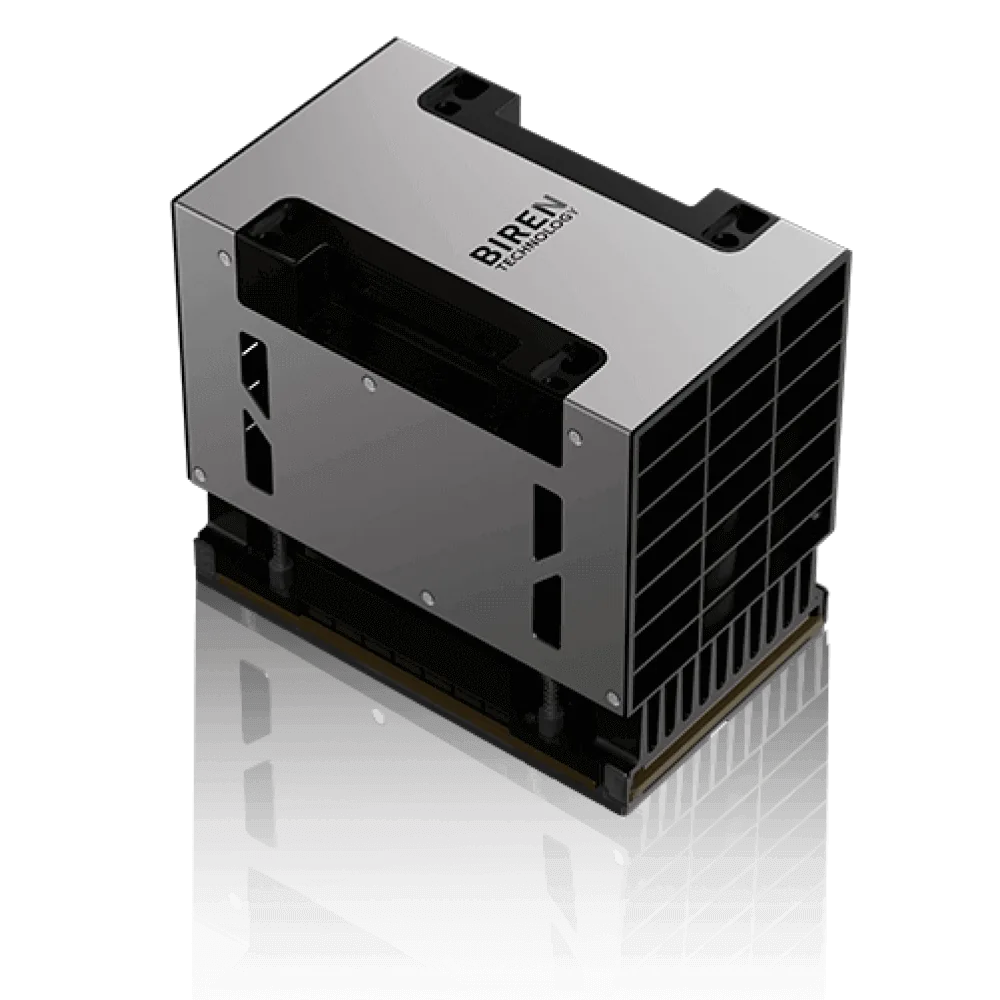
Biren
BIREN 106M
Module OAM à air pour entraînement IA Voir les détails →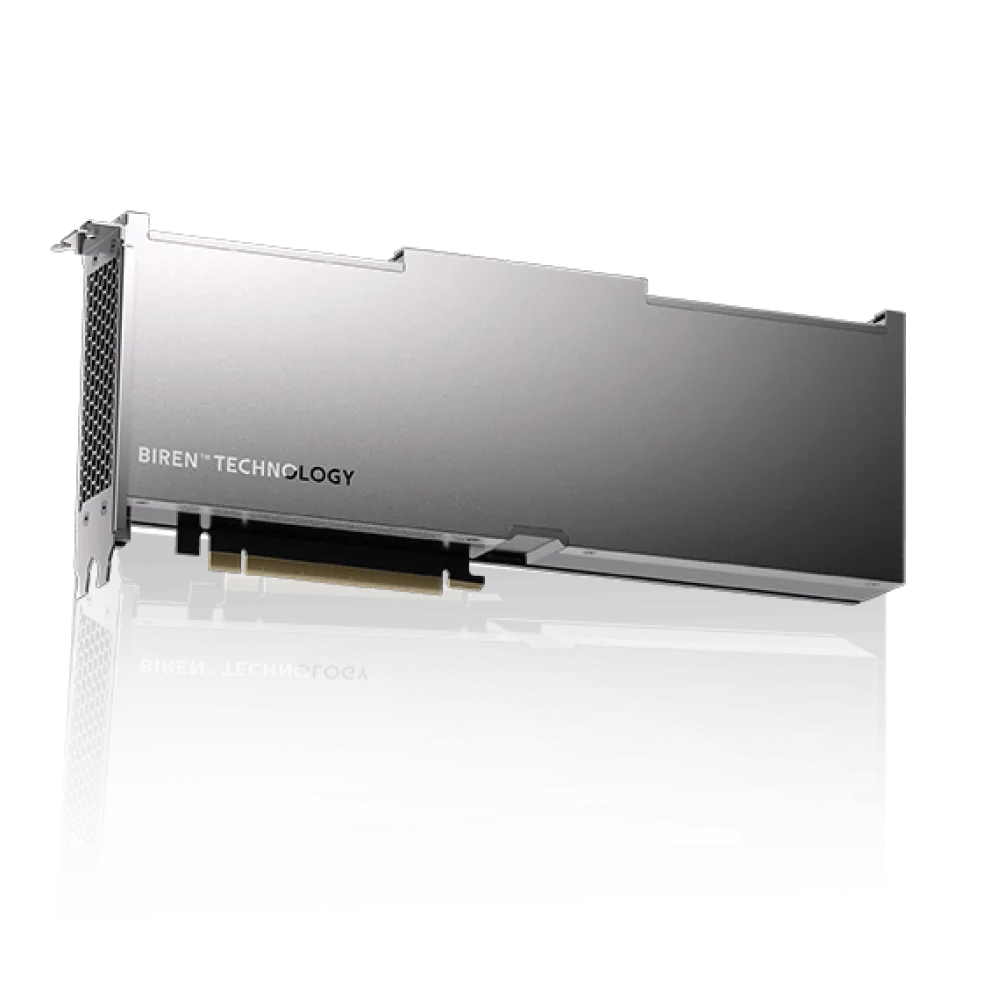
Biren
BIREN 166C
Carte accélératrice PCIe d'inférence haute performance pour centres de données Voir les détails →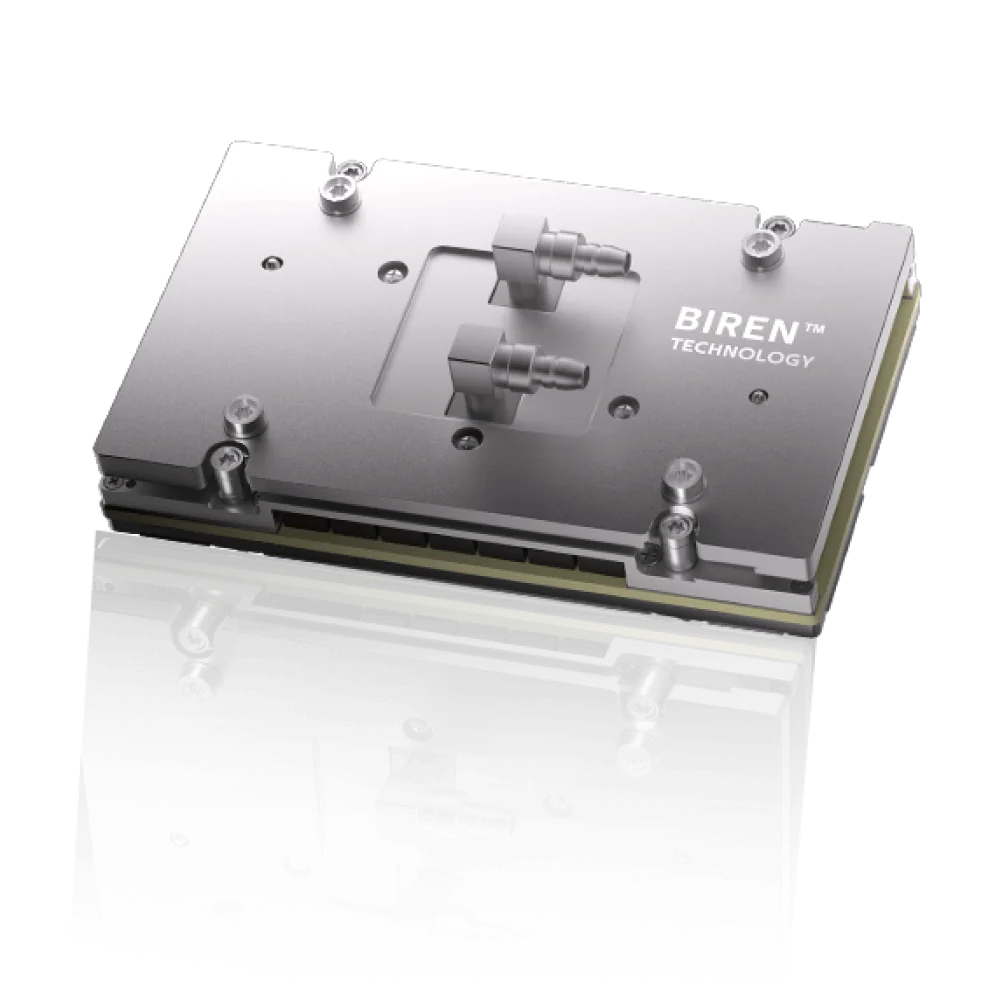
Biren
BIREN 166L
Module OAM refroidi par liquide (cold-plate) pour entraînement et inférence convergés Voir les détails →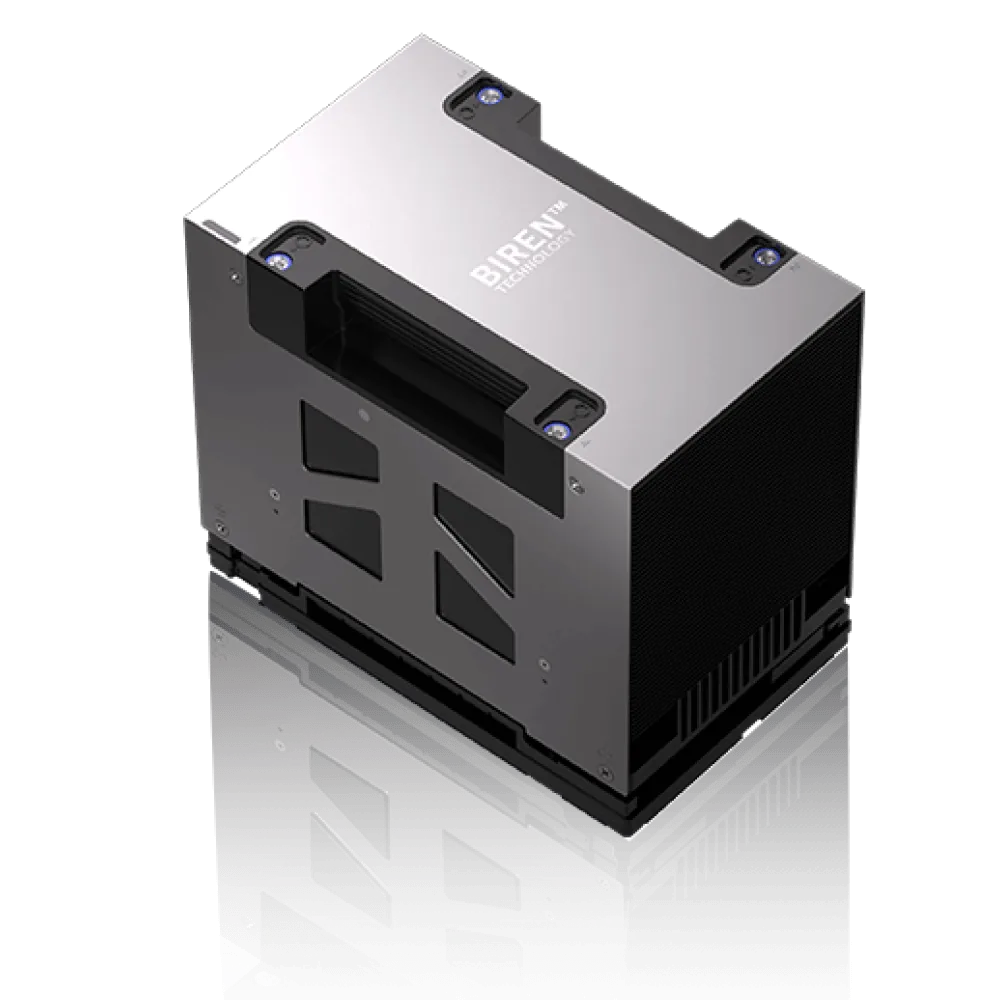
Biren
BIREN 166M
Module OAM à air pour entraînement et inférence convergés (OAM V1.1) Voir les détails →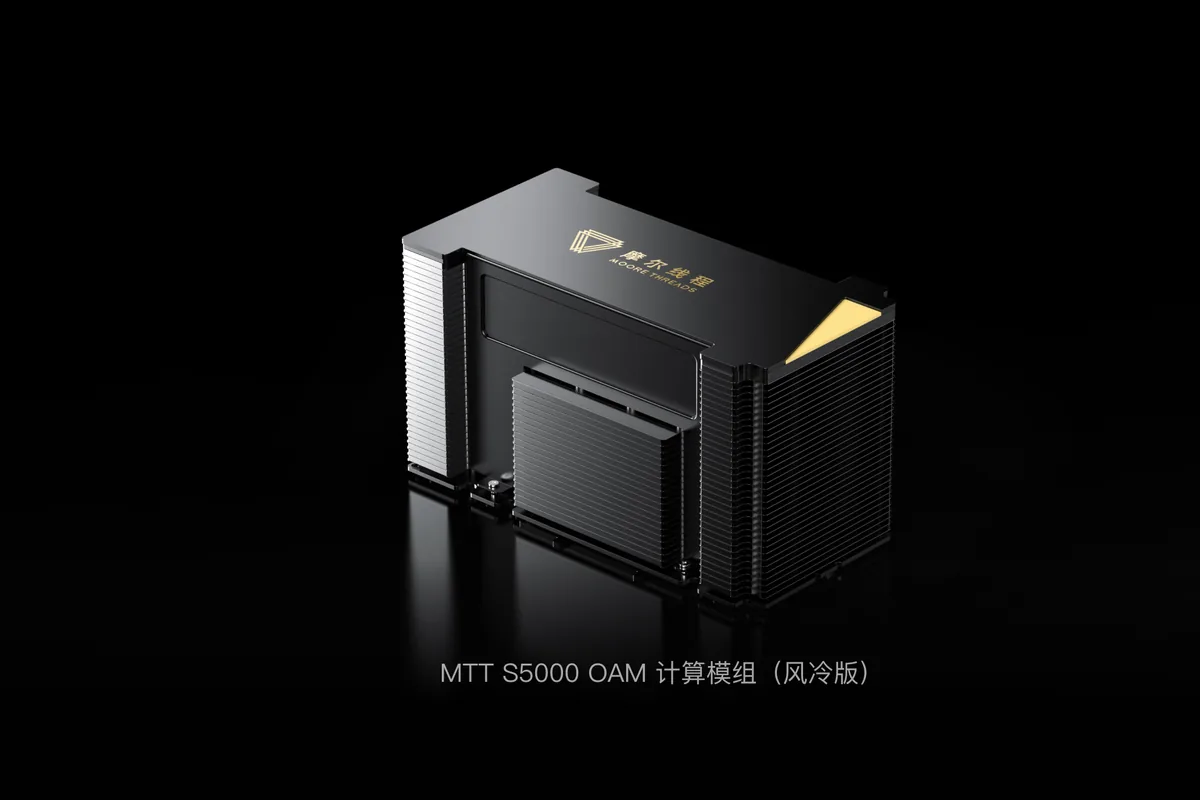
Moore Threads
MTT S5000
Carte GPU de calcul intelligent tout-en-un pour entraînement et inférence Voir les détails →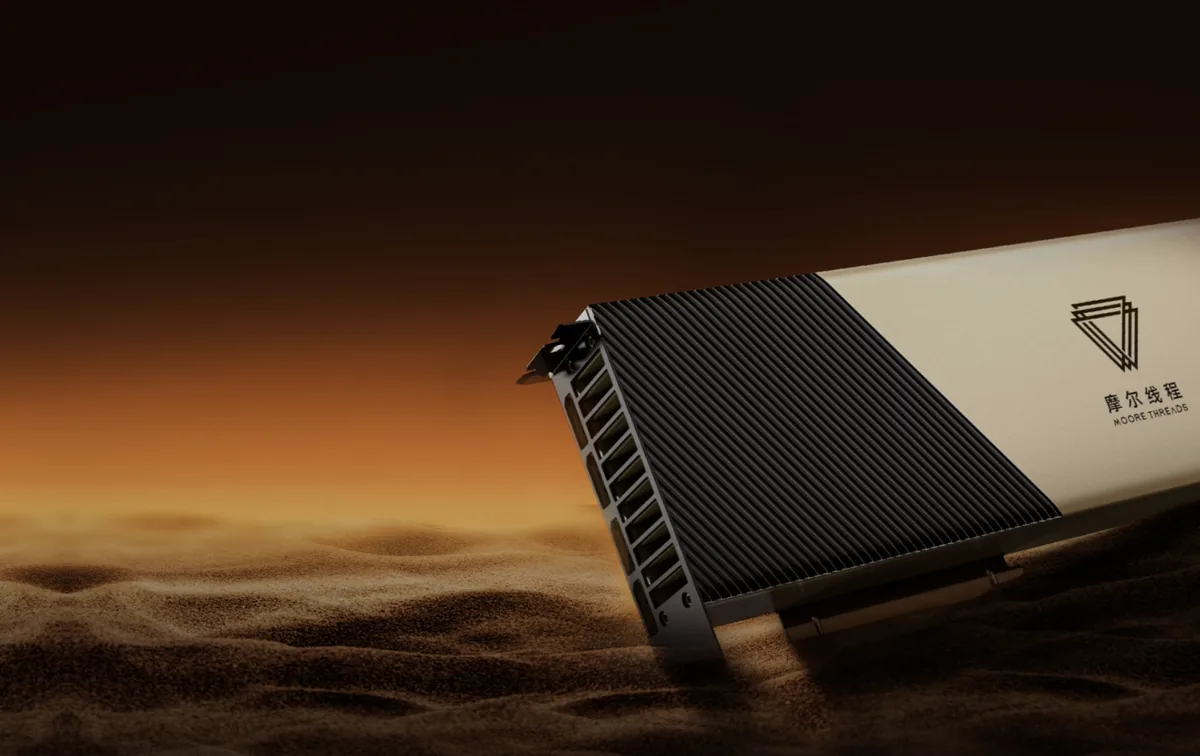
Moore Threads
MTT S4000
Carte accélératrice de calcul intelligent pour grands modèles Voir les détails →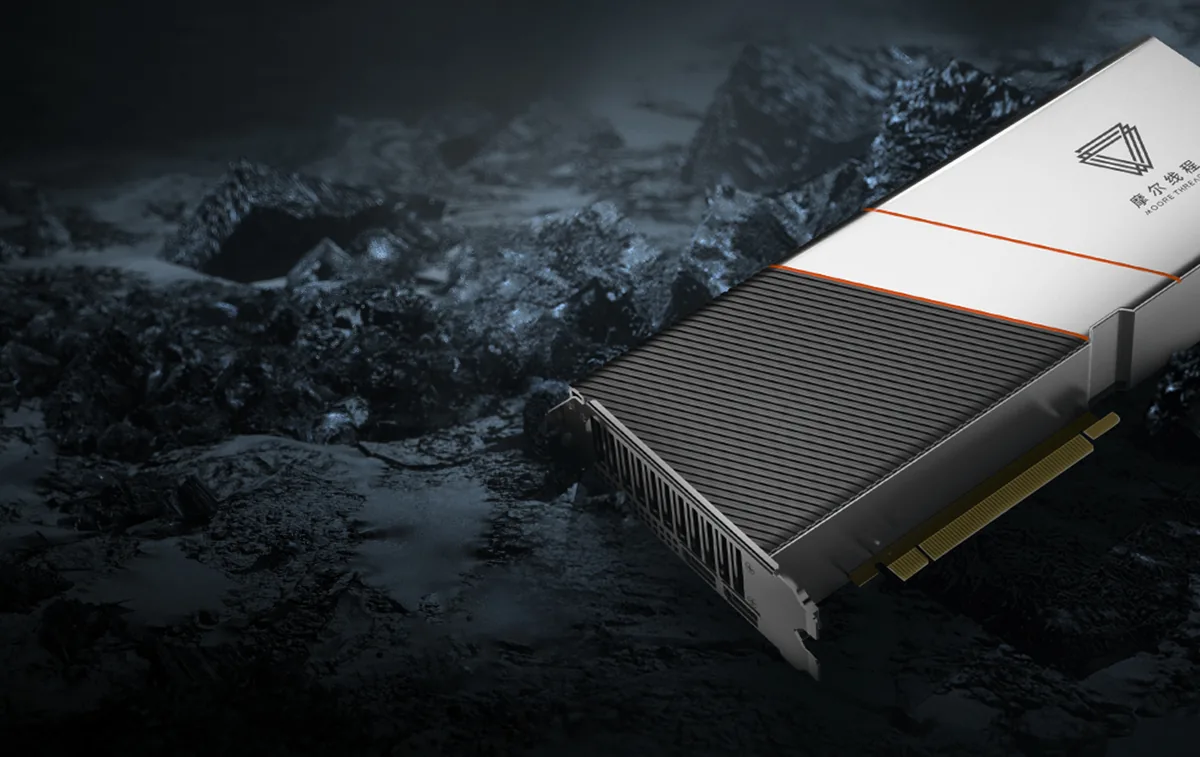
Moore Threads
MTT S3000
GPU de serveur tout-en-un Voir les détails →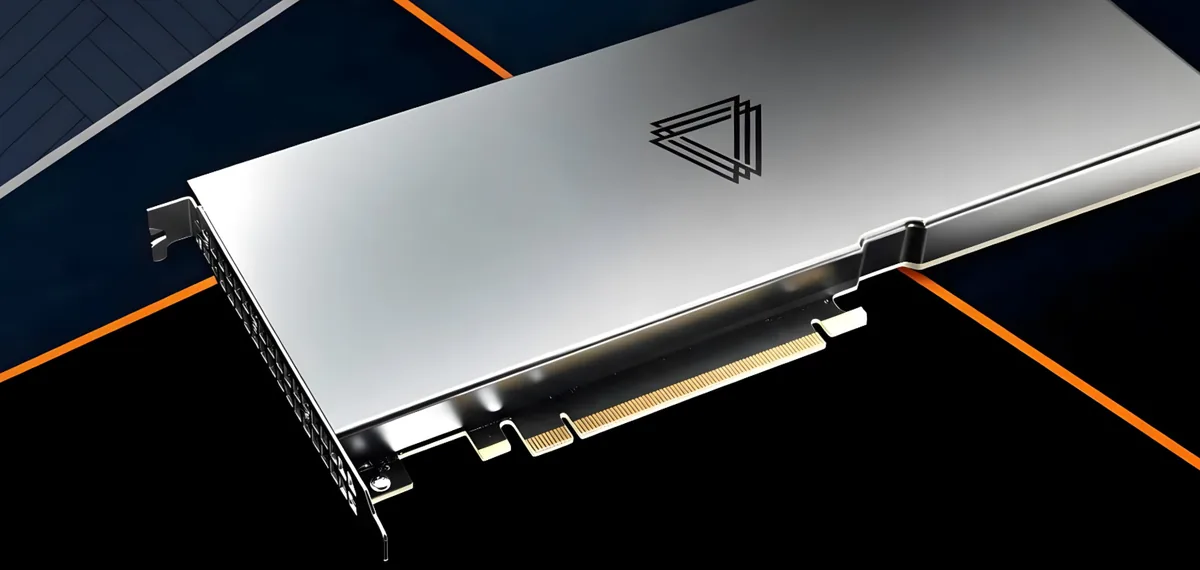
Moore Threads
MTT S2000
GPU de serveur tout-en-un basse consommation pour charges cloud-native Voir les détails →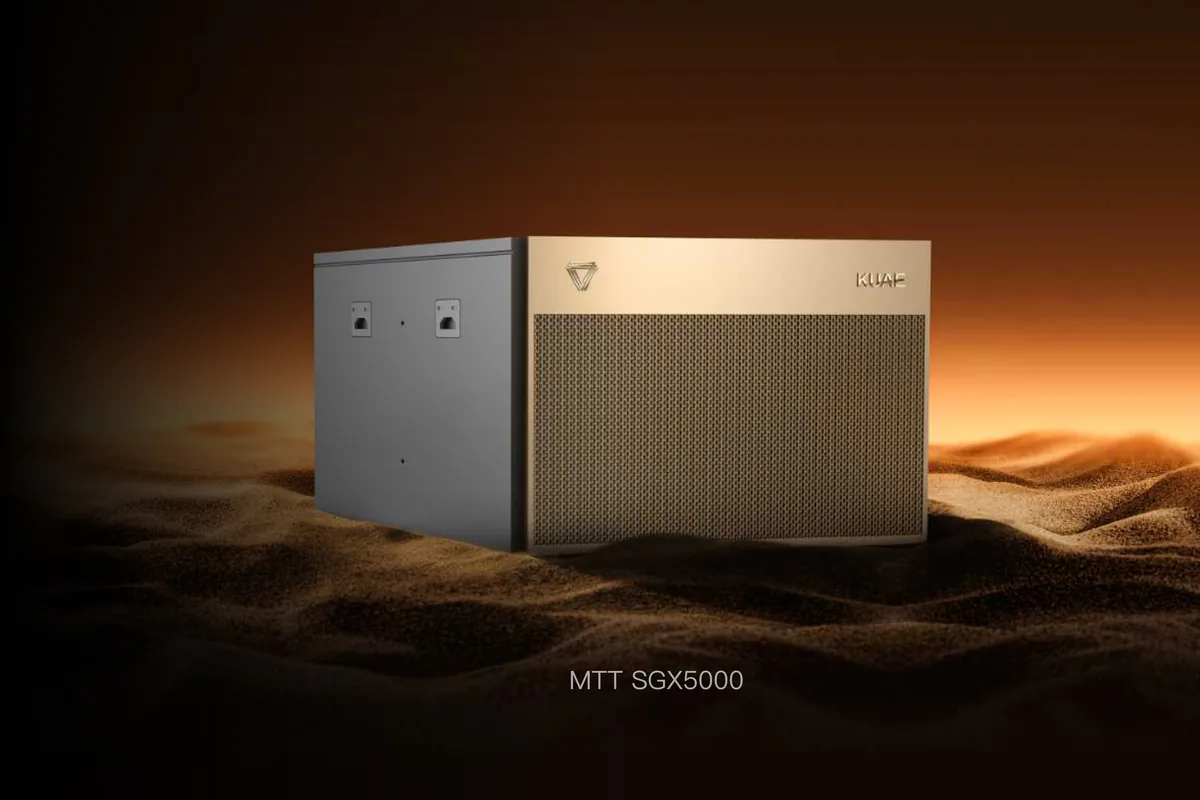
Moore Threads
MTT SGX5000
Serveur IA intégré tout-en-un pour entraînement et inférence convergés Voir les détails →
Moore Threads
MCCX D800 X1
Appliance serveur IA tout-en-un pour grands modèles (8 GPU) Voir les détails →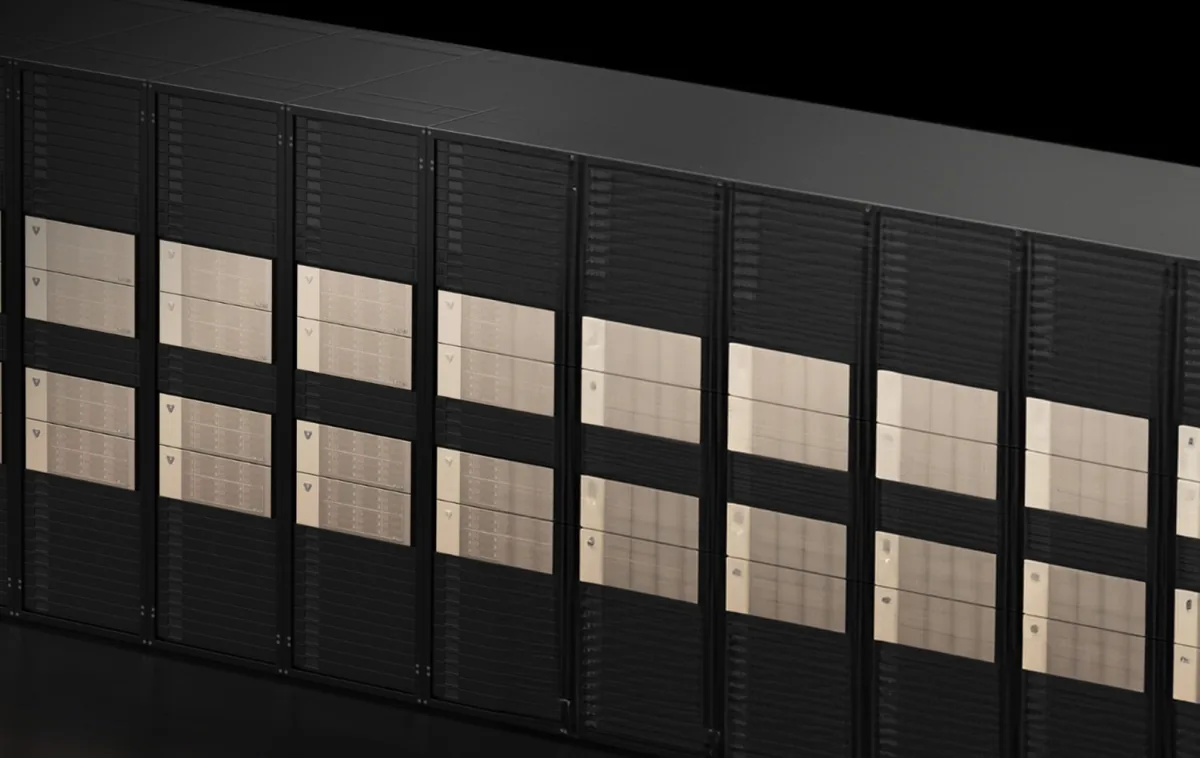
Moore Threads
MTT KUAE
Solution complète pour centres de calcul intelligent Voir les détails →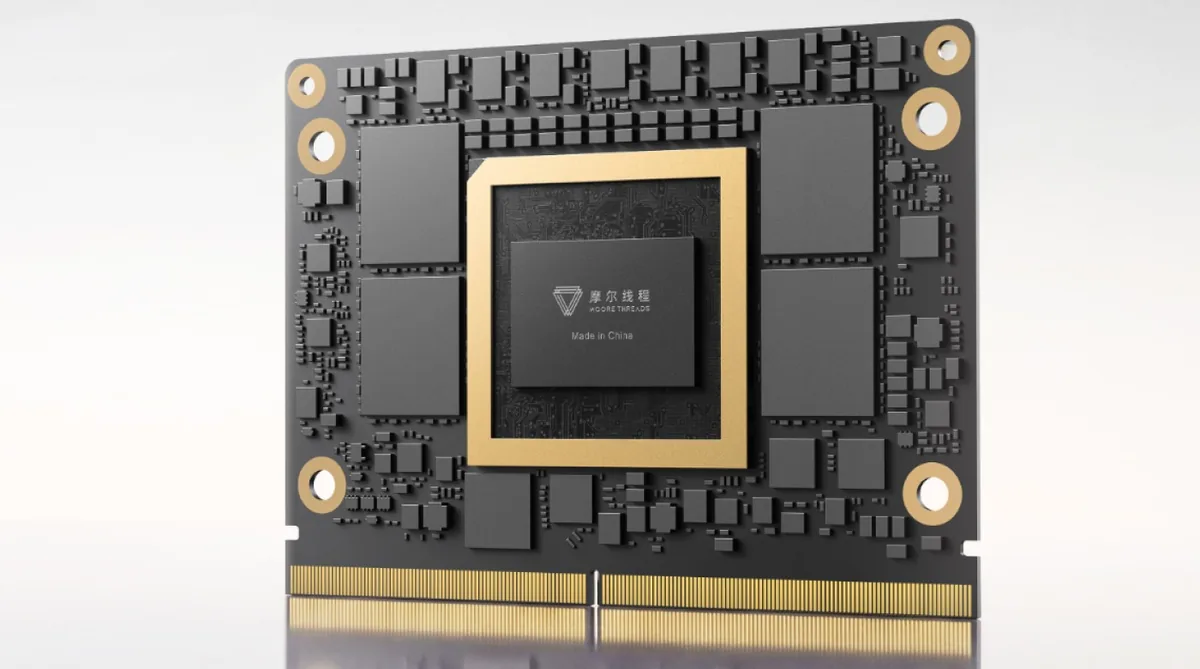
Moore Threads
MTT E300
Module IA dédié aux scénarios edge embarqués Voir les détails →
Alibaba
Hanguang 800 NPU (AI Inference Chip)
Première puce d'inférence IA (NPU) d'Alibaba, pour la recherche, la recommandation, la... Voir les détails →
Alibaba
Zhenwu M890 All-Scenario Training & Inference AI Chip
Puce IA tout-en-un pour entraînement et inférence, 100 % autonome, FP8/FP4 et... Voir les détails →
Alibaba
Zhenwu V900 Training & Inference AI Chip
Puce IA haute performance entraînement/inférence, 216 Go, 1200 Go/s entre puces, Scale-Up... Voir les détails →
Alibaba