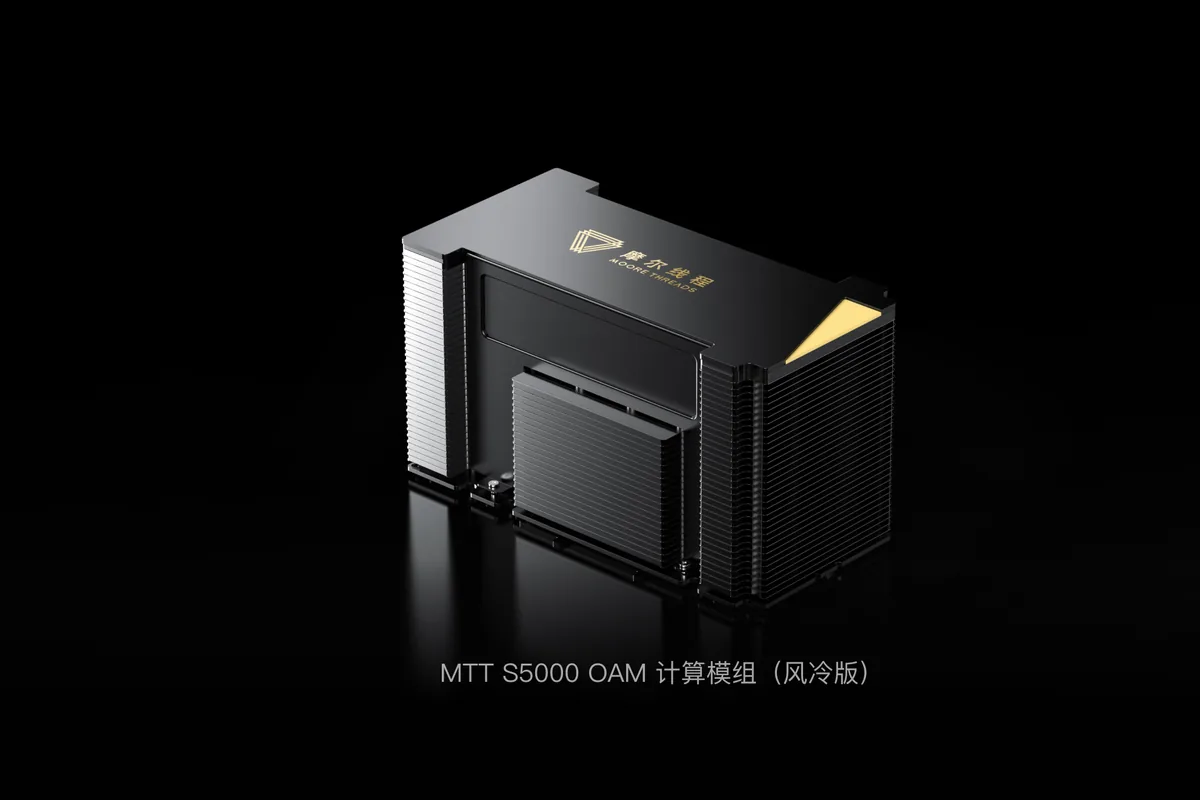
Moore Threads · Beschleunigerkarte
MTT S5000
Die MTT S5000 ist eine voll ausgestattete intelligente Rechen-GPU für die Ära der generativen AI, eigens entwickelt für Großmodelltraining, -inferenz und HPC. Sie ist mit dem neuen PH100-Chip auf der „PingHu“-Architektur ausgestattet und bietet Präzisionsunterstützung von FP8 bis FP64. Auf Basis der vierten MUSA-Full-Stack-Plattform werden gängige Frameworks wie PyTorch, Megatron-LM, vLLM und SGLang nativ unterstützt, mit niedrigen Codemigrationskosten. Der PH100-Chip hat als einer der ersten die Sicherheits- und Zuverlässigkeitsbewertung des China Information Technology Security Evaluation...
Wichtigste Merkmale
- Hardware-natives FP8, über 30 % Leistungszuwachs beim Training moderner Architekturen (DeepSeek, Qwen u. a.)
- für 10000-Karten-Cluster ausgelegt, Linearität von 1000 auf 10000 Karten bis 95 %, chip- bis systemweite RAS steigert die Trainingserfolgsquote um über 30 %
- bei 16k-Langsequenzen pro Karte Prefice-Throughput ≥4000 Tokens/s, Decode ≥1000 Tokens/s (PD-getrennt, 6 Server mit je 8 S5000-Karten, natives FP8-Messung)
- auf 2 Knoten mit 16 Karten wird das vollständige Wan2.1-Videogenerierungsmodell trainiert, mit 61.83 samples/s und MFU 51 %
- native FP64-Doppelpräzision
- MUSA ist CUDA-Syntax hochkompatibel
- OAM-Modul in Luft- und Flüssigkühlvariante
Technische Daten
| Chip | PH100 |
|---|---|
| Architektur | PingHu, 4. Generation MUSA |
| Genauigkeit | FP8/FP16/BF16/FP32/TF32/FP64 |
| Bauform | OAM compute module (air-cooled / liquid-cooled) |
| Interconnect | MTLink |
| On-Card-Speicher und Rechenleistung pro Karte | keine Quantitätswerte auf der offiziellen Seite veröffentlicht |
Typische Einsatzbereiche
Training, Fine-Tuning und Inferenz großer SprachmodelleText-zu-Video- und Bildgenerierungwissenschaftliches Rechnen und AI for Science (Quantentechnologie, Embodied AI, Weltmodelle, medizinische Bildgebung, Genomforschung, industrielle Großmodelle, Physiksimulation, Molekulardynamik)
Ähnliche Produkte
Moore Threads
MTT S4000
Großmodell-Beschleunigungskarte Details ansehen →
Moore Threads
MTT S3000
Voll ausgestattete Server-GPU Details ansehen →
Moore Threads
MTT S2000
Stromsparende voll ausgestattete Server-GPU für Cloud-Native-Szenarien Details ansehen →
Moore Threads