Huawei Atlas · Compute-Server
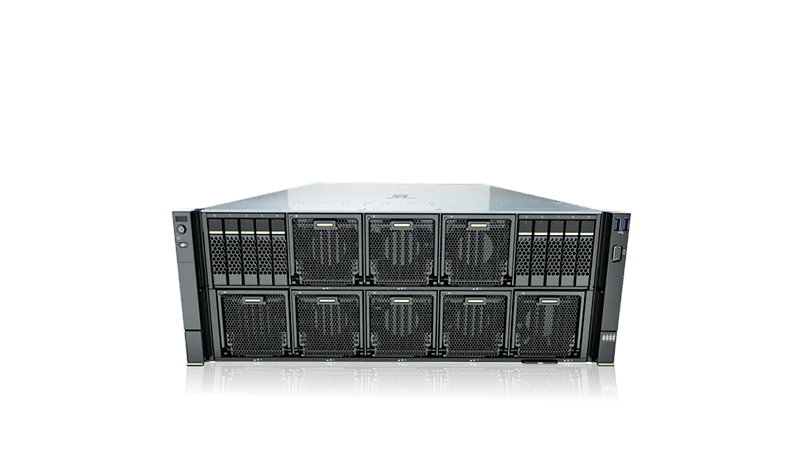
Atlas 800I A2 Inference Server
Der Atlas 800I A2 Inferenzserver nutzt ein hocheffizientes Inferenzkonzept mit 8 Modulen und bietet starke AI-Inferenzleistung. Er zeichnet sich durch Rechenleistung, Speicherbandbreite und Interconnect-Fähigkeit aus und ist breit einsetzbar in der generativen Großmodell-Inferenz, beispielsweise intelligenter Kundendienst, Textgenerierung, Wissensaufbereitung und weiteren content-generierenden Szenarien. Er unterstützt NPU-Interconnect und steigert so die Inferenzeffizienz großer Modelle.
Wichtigste Merkmale
- Hocheffiziente Inferenz mit 8 Modulen
- starke Rechenleistung, Speicherbandbreite und Interconnect-Fähigkeit
- unterstützt NPU-Interconnect zur Steigerung der Großmodell-Inferenzeffizienz
Technische Daten
| Bauform | 4U AI server |
|---|---|
| CPU | Kunpeng 920 x4 |
| Systemspeicher | 32x DDR4 DIMM slots up to 3200 MT/s |
| interner Interconnect | optional full NPU mesh, 392 GB/s aggregate |
| externes Netzwerk | 8x 200GE QSFP RoCE |
| PCIe | up to 3x PCIe 4.0 |
| redundant Netzteile | 4x 2.6 kW, 2+2 |
| Kühlung | air-cooled |
| Modell der Module und Gesamt-Rechenleistung | nicht veröffentlicht |
Typische Einsatzbereiche
Generative Großmodell-Inferenz: intelligenter Kundendienst, Textgenerierung, Wissensaufbereitung und weitere content-generierende Szenarien
Ähnliche Produkte
Huawei Atlas
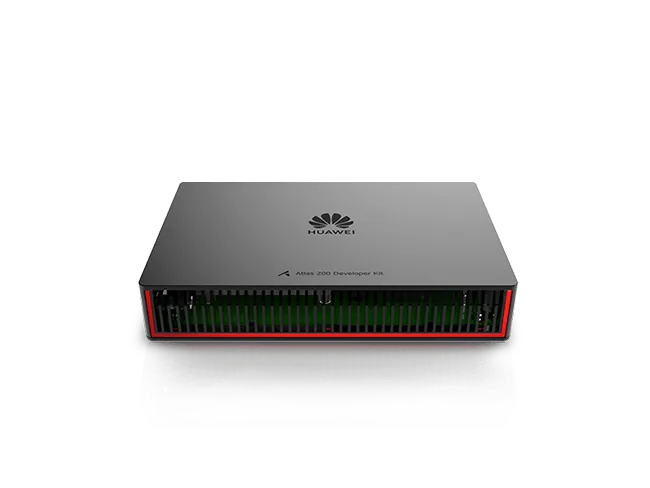
Atlas 200I DK A2 Developer Kit
Einfaches Entwicklungs-Kit für schnelle AI-Innovation Details ansehen →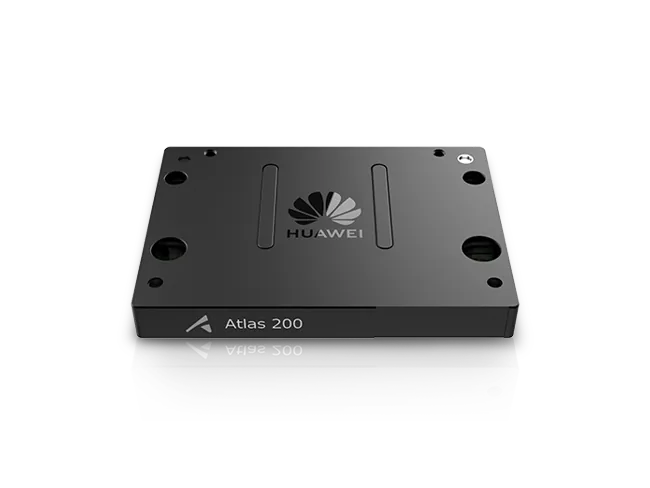
Huawei Atlas
Atlas 200I A2 Acceleration Module
In Edge-Geräte, Roboter und Drohnen eingebettetes AI-Beschleunigungsmodul Details ansehen →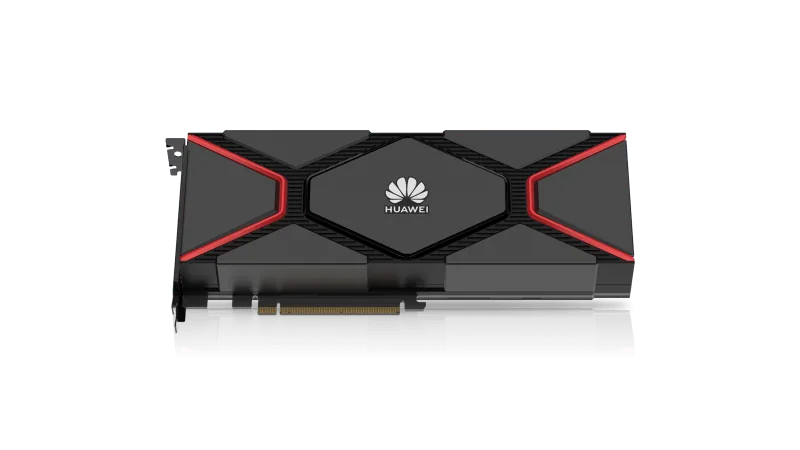
Huawei Atlas
Atlas 300I A2 Inference Card
AI-Inferenzkarte, in Server integriert, mit starker AI-Rechenleistung Details ansehen →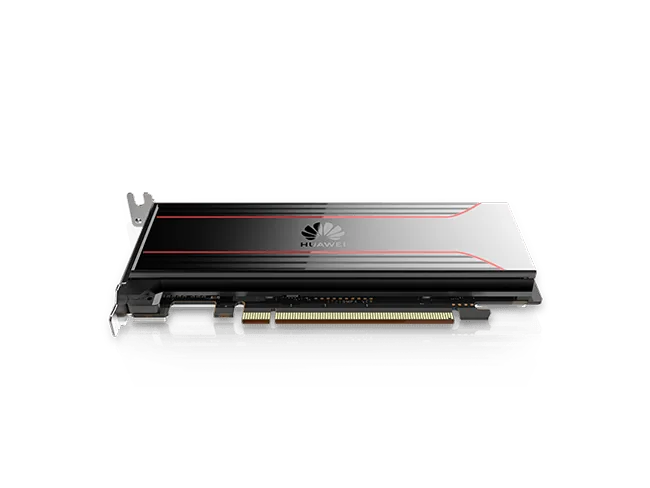
Huawei Atlas